
NVIDIA Auto Ontology 接入 ModelGo:配置与排障
NVIDIA Auto Ontology 会从数据库元数据生成语义层,把自然语言问题转换成 SQL,并返回查询结果、SQL 和处理步骤。本教程使用 ModelGo 承担推理与实体抽取,Embedding 和 Rerank 暂时保留 NVIDIA 服务,搭建一套可解释的自然语言查数系统。
架构
Auto Ontology 由前端、Text-to-SQL 后端、数据摄取服务和 PostgreSQL/pgvector 组成。模型会参与术语抽取、候选数据选择、SQL 生成、校验和修复。
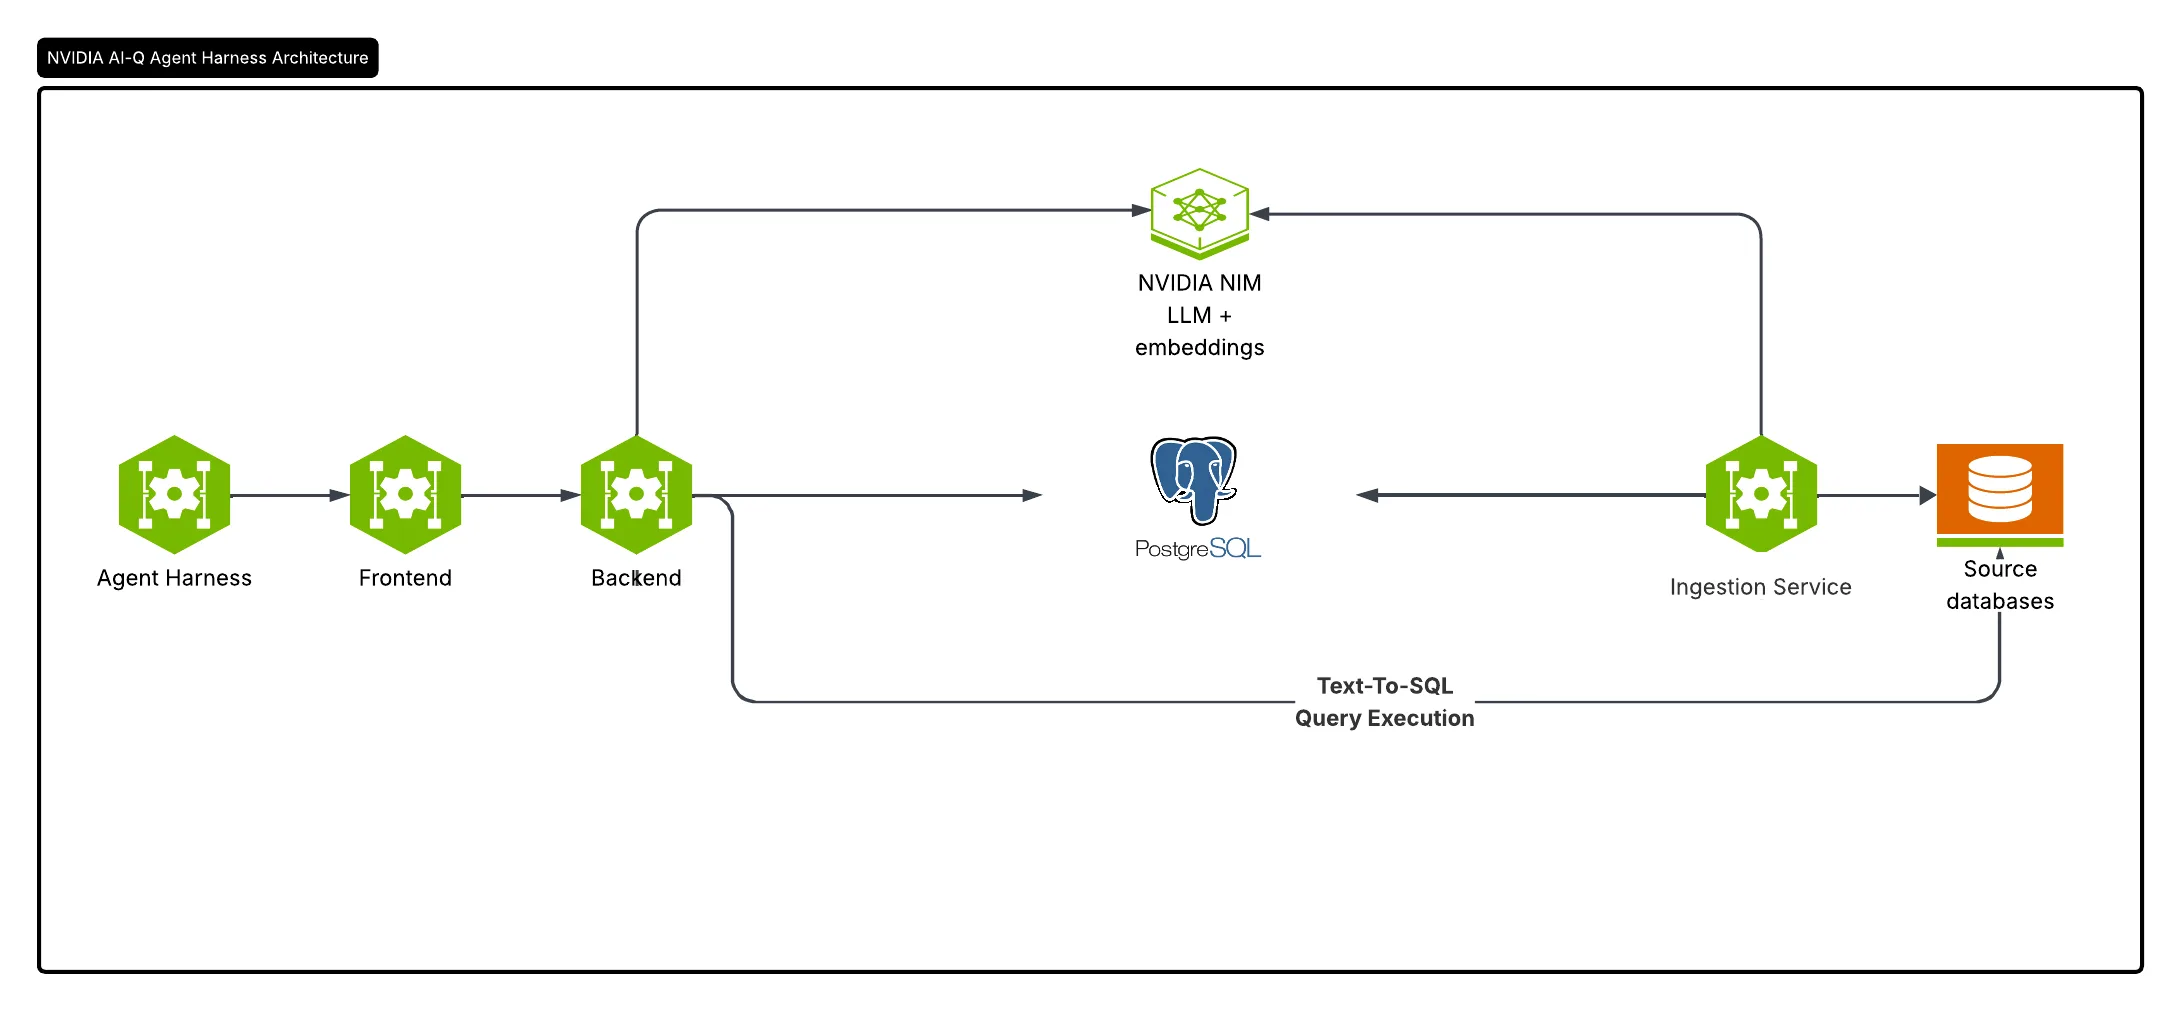
本文完成后的调用关系如下:
| Auto Ontology 角色 | 用途 | 本文使用的服务 |
|---|---|---|
REASONING | 语义编译、SQL 生成、解释与可回答性判断 | ModelGo Chat Completions |
NON_REASONING | 意图识别、实体抽取、候选选择与 SQL 检查 | ModelGo Chat Completions |
EMBED | 为表、字段、术语与 SQL 属性生成向量 | NVIDIA Embeddings |
RERANK | 对候选数据进行重排 | NVIDIA Rerank |
准备工作
开始前准备:
- Docker 与 Docker Compose v2;
- Python 3.12+ 和 uv;
- 在 ModelGo 控制台创建的 API Key;
- 一个 NVIDIA API Key,用于 Embedding 和 Rerank;
- 至少 16 GB 可用内存,以及用于测试的 PostgreSQL 数据库。
本文基于 Auto Ontology 提交 fc43a826(项目版本 1.2.0)的配置和源码结构编写。上游版本更新后,请先对照其 .env.example 和 auto_ontology/utils/llm_invoke.py。
1. 选择并验证 ModelGo 模型
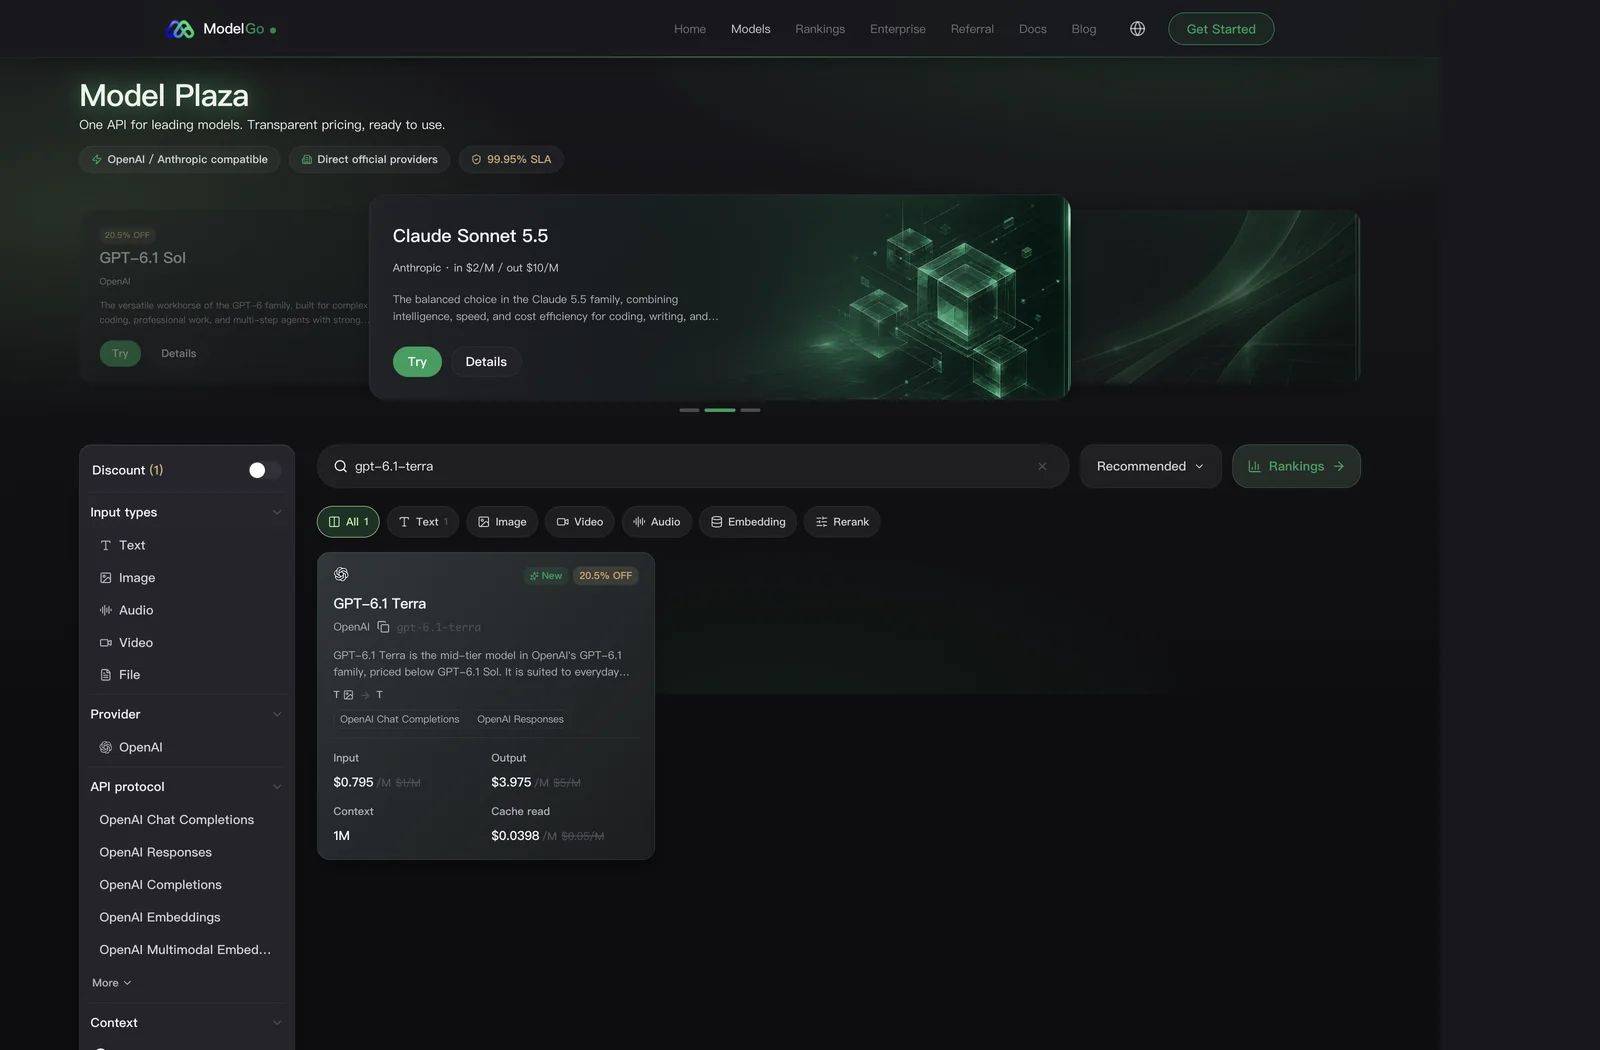
在模型广场选择支持 OpenAI Chat Completions 的文本模型,复制卡片上的 API ID。模型显示名称和 API ID 可能不同,配置时使用 API ID。
先查询当前 API Key 实际可调用的模型:
export MODELGO_API_KEY="mgk_你的API_Key"

curl https://api.modelgo.ai/v1/models \
  -H "Authorization: Bearer $MODELGO_API_KEY"
再用准备采用的模型做一次非流式调用。把 <model> 替换成上一步返回的逻辑模型名:
curl https://api.modelgo.ai/v1/chat/completions \
  -H "Authorization: Bearer $MODELGO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<model>",
    "messages": [
      {"role": "user", "content": "只返回 JSON:{\"ready\":true}"}
    ],
    "response_format": {
      "type": "json_schema",
      "json_schema": {
        "name": "readiness",
        "strict": true,
        "schema": {
          "type": "object",
          "properties": {"ready": {"type": "boolean"}},
          "required": ["ready"],
          "additionalProperties": false
        }
      }
    },
    "max_tokens": 128
  }'
Auto Ontology 会大量使用 JSON Schema 结构化输出。普通对话成功但这个请求失败时,不要继续部署;请在模型的参数页确认 response_format 能力,或更换模型。
2. 下载 Auto Ontology
git clone https://github.com/NVIDIA/auto-ontology.git
cd auto-ontology
git checkout fc43a82600e18b19d159c52023f54f5572f537ac
cp .env.example .env
这个提交与本文截图和配置一致。准备生产部署时,可以升级到经过验证的更新提交,但不要长期跟随浮动的 main。
3. 让 ModelGo 使用 OpenAI 客户端
Auto Ontology 1.2.0 会根据模型名前缀选择客户端:只有以 openai/、azure/ 或 aws/ 开头的模型名才进入 ChatOpenAI,其他名称会进入 ChatNVIDIA。ModelGo 的逻辑模型名通常没有这些前缀,因此需要按 endpoint 识别 ModelGo。
编辑 auto_ontology/utils/llm_invoke.py:
- 在 import 区域加入:
``python from urllib.parse import urlparse ``
- 在
_build_client中,把原来的客户端判断:
``python if model.startswith(("openai/", "azure/", "aws/")): ``
改为:
```python endpoint_host = (urlparse(base_url).hostname or "").lower() is_modelgo = endpoint_host in {"api.modelgo.com", "api.modelgo.ai"}
if is_modelgo or model.startswith(("openai/", "azure/", "aws/")): ```
这个修改只改变客户端选择,不会记录或转发额外凭据。修改后先检查语法:
uv run python -m py_compile auto_ontology/utils/llm_invoke.py如果你使用的是更新版本,并且源码已经能按 OpenAI-compatible endpoint 选择客户端,则跳过本节。
4. 配置四类模型
编辑 .env。以下示例将推理模型接入 ModelGo,同时保留 NVIDIA Embedding 和 Rerank;把所有占位符替换成真实值:
# ModelGo:推理与快速任务
REASONING_ENDPOINT=https://api.modelgo.ai/v1
REASONING_API_KEY=mgk_你的API_Key
REASONING_MODEL=<reasoning_model>

NON_REASONING_ENDPOINT=https://api.modelgo.ai/v1
NON_REASONING_API_KEY=mgk_你的API_Key
NON_REASONING_MODEL=<non_reasoning_model>

# NVIDIA:Embedding
EMBED_ENDPOINT=https://integrate.api.nvidia.com/v1
EMBED_API_KEY=nvapi_你的API_Key
EMBED_MODEL=nvidia/nemotron-3.5-embed-1b

# NVIDIA:Rerank
RERANK_ENDPOINT=https://ai.api.nvidia.com/v1/retrieval/nvidia/nemotron-3.5-rerank-8b/reranking
RERANK_API_KEY=nvapi_你的API_Key
RERANK_MODEL=nvidia/nemotron-3.5-rerank-8b
推荐先让 REASONING 和 NON_REASONING 使用同一个已验证模型。全流程跑通后,再把 NON_REASONING_MODEL 换成速度更快、成本更低且仍支持结构化输出的模型。
:::warning
- endpoint 填
https://api.modelgo.ai/v1,不要追加/chat/completions。 - 模型名使用 ModelGo 逻辑模型名,不要自行添加
openai/前缀。 .env包含明文凭据,不要提交到 Git,也不要把包含 Key 的终端或编辑器画面放进截图。- 摄取和查询必须使用同一个 Embedding 模型;更换模型后应重新生成向量。
:::
5. 配置数据库与本地账号
继续在 .env 中设置数据库和 Auto Ontology 本地账号。下面以官方 Wide World Importers 示例库为例:
POSTGRES_HOST=localhost
POSTGRES_PORT=5432
POSTGRES_USER=postgres
POSTGRES_PASSWORD=<new_postgres_password>
POSTGRES_DATABASE=auto_ontology

CONNECTION_STRINGS=postgresql://postgres:<new_postgres_password>@postgres:5432/wideworldimporters

AUTH_SECRET=<long_random_string>
APP_URL=http://localhost:3000
AUTO_ONTOLOGY_ADMIN_EMAIL=admin@example.com
AUTO_ONTOLOGY_ADMIN_PASSWORD=<new_admin_password>
PGADMIN_EMAIL=admin@example.com
PGADMIN_PASSWORD=<new_pgadmin_password>
生成 AUTH_SECRET:
openssl rand -base64 32启动 PostgreSQL,并导入官方示例数据:
docker compose up -d --wait postgres

git clone https://github.com/NVIDIA/auto-ontology-eval.git ../auto-ontology-eval
(cd ../auto-ontology-eval && \
  uv sync && \
  cp .env.example .env && \
  POSTGRES_PASSWORD='<new_postgres_password>' \
  uv run python scripts/seed/seed_wwi.py \
    --database-name wideworldimporters --drop)
6. 启动并进行语义编译
docker compose up -d --build
docker compose ps
打开 http://localhost:3000,使用 .env 中的管理员账号登录。进入 Settings → Semantic Compilation,开启语义编译,等待页面显示 Semantic compilation is ready。
首次摄取和编译会产生较多模型请求。遇到 429 或 503 时,先降低并发:
LLM_MAX_INFLIGHT=2然后重启 Auto Ontology 服务再试。不要通过无限重试掩盖模型权限、参数或 endpoint 配置错误。
7. 提问并检查结果
在 Chat 中先问一个能用示例库回答的问题:
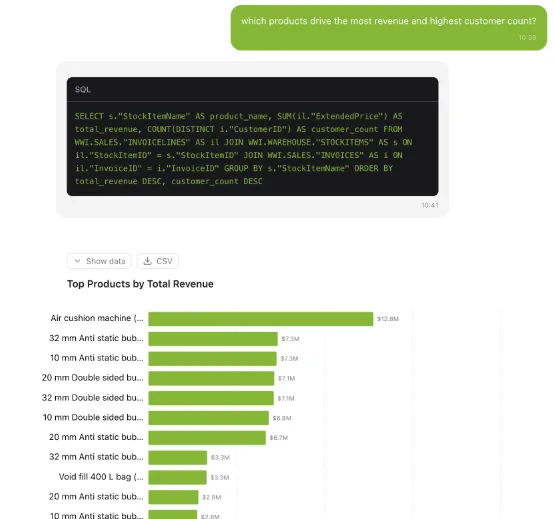
Which products drive the most revenue and highest customer count?
成功结果应同时包含:
- 自然语言答案;
- 实际执行的 SQL;
- 查询数据或图表;
- 术语解析、表关系与校验步骤。
同时在 ModelGo 控制台检查调用日志,确认请求使用了你配置的逻辑模型,并观察状态码、延迟和 token 用量。只有普通 curl 成功、但语义编译失败时,优先检查结构化输出和工具调用能力。
常见问题
- 启动后仍请求 NVIDIA Chat 模型:确认
REASONING_ENDPOINT、NON_REASONING_ENDPOINT已设置,并完成了第 3 节的客户端选择修改;重建镜像而不是只重启旧容器。 401:检查mgk_API Key 是否完整,且.env中没有引号、空格或换行。403或模型不可用:通过GET /v1/models确认该 Key 有权调用对应逻辑模型。404:ModelGo endpoint 应为https://api.modelgo.ai/v1,不要填写完整的/chat/completions地址。- 结构化输出校验反复失败:确认模型支持
response_format或工具调用;普通文本响应成功不能证明它适合 Auto Ontology。 - Embedding 返回
unsupported_parameter:本文没有把 Embedding 接入 ModelGo;确认EMBED_ENDPOINT仍指向所选 Embedding 提供方。 - 检索结果突然变差或 pgvector 维度报错:摄取和查询使用了不同的 Embedding 模型。恢复原模型,或清理旧向量后完整重新摄取。
- 调用量高于预期:语义编译会并行处理表和字段。先缩小测试数据库,再降低
LLM_MAX_INFLIGHT,全流程稳定后再扩容。
下一步
- 将自己的 PostgreSQL、MySQL、Snowflake、ClickHouse 或其他受支持数据源写入
CONNECTION_STRINGS; - 为
NON_REASONING选择更经济的结构化输出模型; - 通过 Auto Ontology 的 MCP Server,把经过语义层约束的查数能力提供给 Agent;
- 在 ModelGo 控制台按 API Key 或项目观察用量和错误,逐步确定生产并发与预算。